围绕生成式人工智能训练数据合法性的争议近日再度升温。一份在《纽约时报》版权诉讼案中解封的法庭文件显示,微软一名高级研究主管曾在内部讨论中形容当前大型语言模型的训练方式可能是“人类历史上最大规模的劳动窃取”,相关表述引发业界广泛关注。 此次曝光的言论来自微软应用科学总监布伦特·赫克特。根据最新公开的法律文件,赫克特在讨论微软、OpenAI以及其他人工智能企业利用互联网海量内容训练模型时,曾将这一过程
新闻动态内容聚合与专题浏览入口
这里集中展示与新闻动态相关的精选内容,涵盖资讯更新、专题观察、重点解读与延伸阅读,帮助用户更快定位所需信息并提升连续阅读体验。
围绕生成式人工智能训练数据合法性的争议近日再度升温。一份在《纽约时报》版权诉讼案中解封的法庭文件显示,微软一名高级研究主管曾在内部讨论中形容当前大型语言模型的训练方式可能是“人类历史上最大规模的劳动窃取”,相关表述引发业界广泛关注。 此次曝光的言论来自微软应用科学总监布伦特·赫克特。根据最新公开的法律文件,赫克特在讨论微软、OpenAI以及其他人工智能企业利用互联网海量内容训练模型时,曾将这一过程
近日美媒在社交媒体发布了一份榜单,列出了NBA历史上最具有统治力的前七名。篮球之神乔丹毫无疑问登顶,但是库里仅仅排名第六,詹姆斯也堪堪杀入前三。现在我们就来盘点这份数据,一项一项拆解。而有一人则是球迷们的意难平。 第7名:邓肯(2003年)——最被低估的单核巅峰 2003年。邓肯出战了81场比赛场均23.3分,12.9篮板,2.9盖帽,率领马刺队夺得60胜,加冕了常规赛的MVP季后赛的邓肯更加恐怖
当地凌晨,巴基斯坦宣布空袭阿富汗境内10处目标,称这些地点用于发射和储存无人机。就在前一天,巴方称拦截了来自阿富汗的无人机,阿方则否认发动袭击。边境交火尚未平息,打击范围已经延伸到阿富汗纵深。 巴基斯坦这轮空袭,瞄准的是它认为能持续制造越境袭击的发射能力。伊斯兰堡想用跨境打击压住国内不断遭遇的安全威胁,并迫使喀布尔管住境内武装。但空袭一旦触及阿富汗的军事设施和城市周边,巴方追求的安全就会与阿方要求
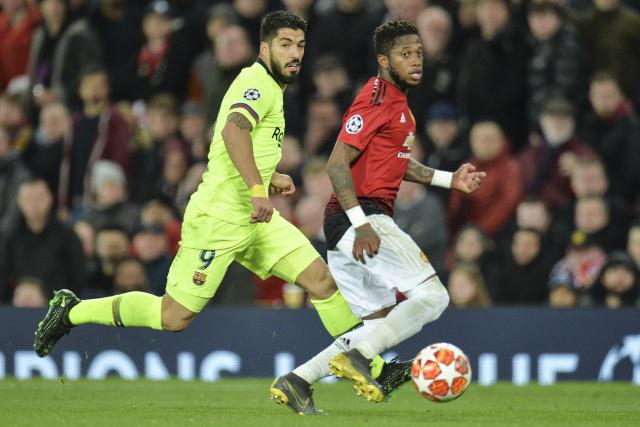
早上七点半,闹钟没响,是被手机里的推送震醒的。屏幕亮起来的那一刻,我没看清比分,只瞥见了“1.25亿”、“1.45亿”这几个词。脑子里“嗡”的一声,不是觉得疼,是一种荒谬感。利物浦0比1输给阿森纳,这本身没什么稀奇的,英超嘛,冷门家常便饭。但这次不同,不同在于那三个名字:维尔茨、巴尔科拉、伊萨克。这三位如今是利物浦进攻端的核心拼图,也是转会市场上最昂贵的奢侈品。 算笔账吧,这很无聊,但很直观。维尔